美东时间 9 月 28 日,AMD 在官网挂出新闻稿:以全股票方式收购世界模型公司 World Labs,交易价值约 82 亿美元,预计年底前完成,尚需监管批准。此为 AMD 史上第二大收购,仅次于 2022 年约 500 亿美元的赛灵思(Xilinx)并购。
李飞飞也发表了公开信《To Seek a Newer World》,开篇不谈钱,而是引用丁尼生勋爵长诗《尤利西斯》:“来吧,我的朋友们,现在去寻找一个更新的世界还不算太晚。” 交易完成后,她将出任 AMD 执行副总裁兼首席科学家,直接向 CEO 苏姿丰汇报,Justin Johnson 和 Ben Mildenhall 两位联创继续带队。
一个教会机器理解图像,一个为机器提供计算的心脏,两位在各自领域走到顶端的华人女性,用一场多数人没预料到的交易走到了一起。故事要从三十多年前新泽西州一家干洗店讲起。
从干洗店到 ImageNet
1992 年,16 岁的李飞飞随母亲从成都飞抵美国新泽西州帕西帕尼,与两年前先行赴美的父亲会合。这个工程师家庭到美国后阶层瞬间清零:一家三口挤在一居室里,家具从路边捡来,父亲靠修相机为生,母亲在杂货店收银,后来借钱盘下一家干洗店,生活才稳住。
她放学后到中餐馆端盘子,周末回家看店,后来考进普林斯顿读物理。周一到周五,她是校园里的高材生,周末仍是那个洗衣店的女儿。1999 年毕业时,华尔街递来的高薪合同没能留住她,她想回答的问题始终没变:机器怎样才能“看见”。2023 年,她把这段经历写进回忆录《我看见的世界》。
“2000 年,我还是一名刚刚进入这个领域的研究生。” 在规则与符号系统主导 AI、多数同行相信手工设计特征的年代,她赌的是数据驱动这条冷门路线:用海量样本教机器看东西。这在当时被不少人视为笨办法。她的实验室后来发起 ImageNet,众包标注 1400 多万张图片、覆盖两万多个类别。2012 年,AlexNet 以断崖优势夺冠,识别错误率比第二名低出近十个百分点,图像数据、神经网络与 GPU 三股力量就此汇合,点燃现代 AI。此后她任谷歌云 AI 首席科学家、从零组建团队,又成为斯坦福以人为本人工智能研究院(HAI)联合创始院长。
当前沿研究的重心从学界转向产业界,她判断要产生最深远的影响,只能下场“直接挑战最大胆、最困难的技术问题”。她自 2024 年 1 月起从斯坦福部分休假。同年 4 月 16 日,World Labs 尚未亮相,她已在 TED 演讲中抛出空间智能,称今天的 AI 是“活在文本里的大脑”。次年 11 月 10 日,她又发表《From Words to Worlds》,把世界模型概括为生成性、多模态、可交互三种能力。从 ImageNet 到世界模型,两次押注是同一个信念:智能始于感知。“这个宇宙并不是由文字组成的,而是由真实存在的事物组成的。”
四个把论文变成产品的人
World Labs 2024 年初成立于帕罗奥图,现总部在旧金山。创始团队的履历几乎是三维生成技术的一条家谱。
Justin Johnson 是李飞飞在斯坦福亲自带出的博士,2019 年起任密歇根大学助理教授并在 Meta FAIR(Meta 旗下的基础人工智能研究院)任访问科学家:实时风格迁移论文是无数滤镜应用的源头,CLEVR (一个由简单几何体构成、专门考察视觉推理能力的合成数据集)成为视觉语言模型的标准考卷,他也是斯坦福明星课程 CS231n(计算机视觉与深度学习课程)的早期助教。
Ben Mildenhall 本科就读斯坦福,博士毕业于加州大学伯克利分校、师从光场相机 Lytro 创始人 Ren Ng,后加入 Google Research。他是 2020 年 NeRF(神经辐射场)的第一作者:只给一组照片,这个模型就能渲染出相机从未到过的角度,论文获 ECCV(欧洲计算机视觉大会)口头报告与最佳论文荣誉提名。ACM(国际计算机学会)在授予他 2025 年 Grace Murray Hopper 奖时评价,NeRF 取代了图形学界沿用数十年的场景表示方法。
Christoph Lassner 先后在 Meta Reality Labs 和 Epic Games 研究高保真数字人与实时渲染,他开发的可微渲染器 Pulsar(一种基于球体表示、渲染过程可求导并参与神经网络训练的高效渲染器,后集成进 Meta 开源三维深度学习框架 PyTorch3D)被视为 3D 高斯泼溅(3DGS)的技术前身,而高斯泼溅正是今天 Atlas 的输出格式。此后 Mildenhall 又做出 MipNeRF、DreamFusion,把神经渲染一路推向文生三维。
三人的研究在同一点汇合:从有限的二维观察中重建、生成并渲染可信的三维世界。几年后,这些分散在论文里的方法将在 Atlas 中汇成一个架构。按公司官网的说法,如今团队横跨研究、工程、机器人、产品、设计与商业,在前沿研究和产品之间维持着紧密的反馈回路。一个细节是,官网列出四位联创,公开信却只点名 Johnson 和 Mildenhall,而收购后继续带队的也正是这两人。
31 个月:一份独角兽速度表
2024 年 9 月 13 日公司走出隐身状态,累计融资 2.3 亿美元、估值超 10 亿美元、团队约 20 人,a16z、NEA、Radical Ventures 领投,英伟达 NVentures、Adobe Ventures 和 Marc Benioff 跟投。12 月 2 日,《Generating Worlds》展示“单图生成可导航三维场景”的原型。
钱到位之后,产品节奏立刻快了起来。2025 年 9 月 16 日,Marble 开放有限测试。10 月 16 日,实时帧模型 RTFM 发布。11 月 12 日,Marble 全面开放,成为公司第一个商业产品,编辑工具 Chisel、Composer 同日落地。创意人员不必懂三维建模,输入文字、图片或视频,就能得到一个可以走进去的立体场景。世界模型头一回,从论文变成了普通人能上手的工具。也是在这一年,一个后来买下整家公司的人,提前走进了故事。
李飞飞回忆,去年双方开始围绕 AMD GPU 做训练与推理优化,苏姿丰本人“很早就是 World Labs 的投资人”和“非常重要的朋友”。
今年 1 月 5 日两人在 CES 同台,21 日 World API 公开。2 月 18 日 B 轮单轮融资 10 亿美元、累计约 12.3 亿美元,Autodesk 出资 2 亿美元(其史上最大初创投资)并任战略顾问,AMD、英伟达、富达、a16z 等参投。互为最大对手的英伟达和 AMD,在这张股东名单上站到了一边。
这家设计软件巨头手握建筑、工程与制造行业的庞大客户,等于为三维世界模型预留了产业出口。此后 4 月 Marble 1.1,6 月提出渲染器、模拟器、规划器分类,7 月 21 日收购 SceniX、28 日提出 Real-to-Sim-to-Real 闭环,9 月 1 日发布 Atlas,近一个月后收购公告落地。从约 20 人到约 70 人(含 SceniX),用时 31 个月。
语言模型预测词,Atlas 预测视角
公开信对 Marble 等产品只字未提,技术笔墨全部给了 Atlas。这款 9 月 1 日发布、目前只向部分合作伙伴早期开放的“全能型世界模型”,把生成、重建、仿真三件事放进了同一个模型,要解决的是计算机视觉的老难题,那就是稀疏视角重建。说白了,只给你几张照片,就要还原出整个三维空间:纯靠几何计算,照片一少就拼不出来。纯靠 AI 生成,又常常换个角度就露馅。Atlas 的做法是把两者缝起来:让生成模型去脑补没拍到的部分,让几何计算守住结构不乱。
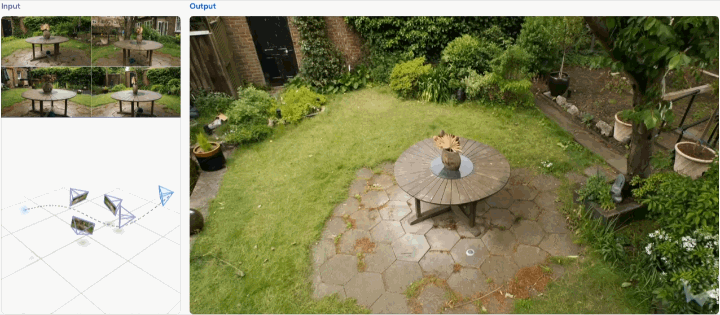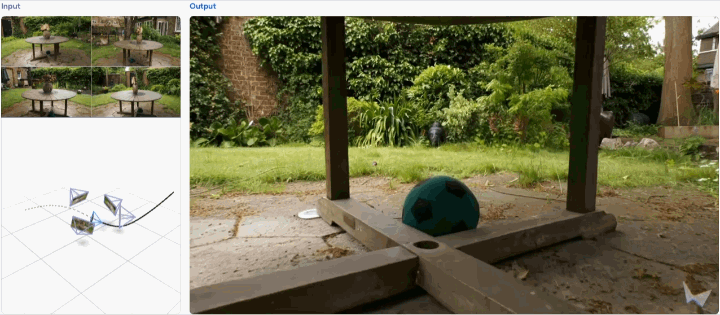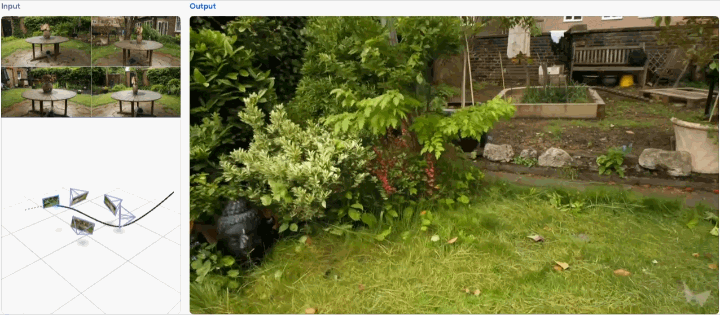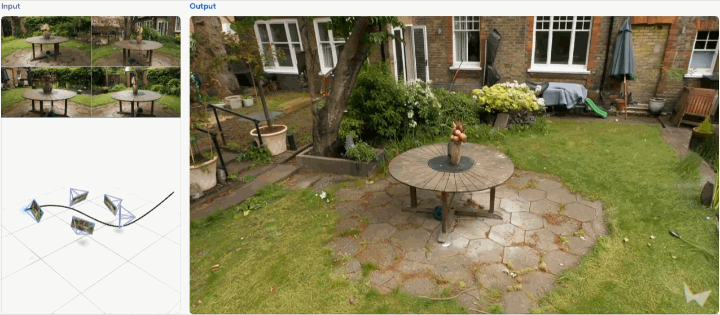
李飞飞给了一个流传很广的类比:“就像大型语言模型可以根据一段文字预测下一个 Token,Atlas 可以根据输入的二维图像,预测下一个观察视角。” 模型完全从零训练,成绩超过了专门为这类任务设计的模型。语言模型猜的是下一个词,Atlas 猜的则是你挪动一步之后应该看到什么。猜得足够准,就说明模型心里已经有了这个空间的样子。演示里,手机围着街景拍大约 24 帧,就能重建出一个可以漫游的场景,输出高斯泼溅或点云,直接接进现有的制作工具。
对照她 6 月给出的分类:Marble 负责渲染,SceniX 与 R2S2R 负责仿真,Atlas 两样都能做,还露出了往“规划器”走的意思,也就是预测机器人采取某个动作之后会发生什么。她点名了三类最先要用的场景:机器人的训练环境、治疗与娱乐内容生成、房地产和建筑设计的空间重建。她也承认,没拍到的地方终究是猜出来的,“看起来对”和“物理上真的对”之间,还隔着一段距离。
机器人缺的不是身体,是训练场
为什么做世界模型的公司,非要买下一家机器人公司?理由很朴素。教机器人学一个动作,如果全在真机上练,又慢又贵又危险。让机械臂当着你的面摔一万次,没有哪家公司耗得起。换成在仿真环境里练,又绕不开一道叫 sim-to-real 的坎:虚拟世界和真实世界总有细微差别,仿真里一处不起眼的物理误差,搬到真机上就会被放大成接连失败。所以行业真正缺的,不是机器人的身体,而是能无限量生成、随意重来的高保真场景。
SceniX 不造机器人,专做这种高保真仿真,覆盖交互数据生成、策略训练、性能评估和边缘故障测试。SceniX 的三位联创各有专攻:李昀烛(Yunzhu Li)本科读北大,在 MIT 拿到博士学位,随后到斯坦福跟随李飞飞做博士后,如今是哥伦比亚大学计算机系助理教授,此前曾在伊利诺伊大学任教。郑昌熙(Changxi Zheng)是哥大计算机科学副教授、康奈尔大学博士,曾在维塔数码和腾讯从事视觉特效与物理仿真。工程负责人胡晓晨(Sonny Hu)先后在腾讯、亚马逊做图像生成与计算机视觉。
两家公司的结缘颇有戏剧性。据李飞飞在那场 a16z 对谈中回忆,2025 年冬天 Marble 全面开放前后,一个陌生账户注册成了客户。她起初不知道对方是谁,打电话过去才发现,是自己在斯坦福的旧博后李昀烛创办的公司。两边越聊越觉得互补,2026 年 7 月 21 日,合作变成了收购。
一周后,World Labs 提出 Real-to-Sim-to-Real(从真实到仿真、再回到真实)的闭环:先把真实环境搬进仿真世界,在里面大规模训练机器人,再把训练好的策略迁回真机验证。到 9 月 Atlas 发布,手机扫一圈就能生成带几何结构的三维场景,闭环最前端的“重建”环节也有了着落。李飞飞说,她想为开发者造一个“多元宇宙”:机器人需要的每一个训练世界,都可以被生成出来。
更大的船
为什么是现在卖?李飞飞的论证很短:Atlas 已证明路线可行,瓶颈不在算法。“我们需要扩大规模、扩大影响范围,同时更加接近硬件……如果缺少专门针对硬件的投入,AI 的效率和规模都会受到限制,AI 也很难真正走出数字世界。” 世界模型训练以海量视频和三维数据为单位,推理要求实时渲染,一家约 70 人的公司即便融到 12 亿美元,也难同时负担基础模型、算力设施与软硬协同。
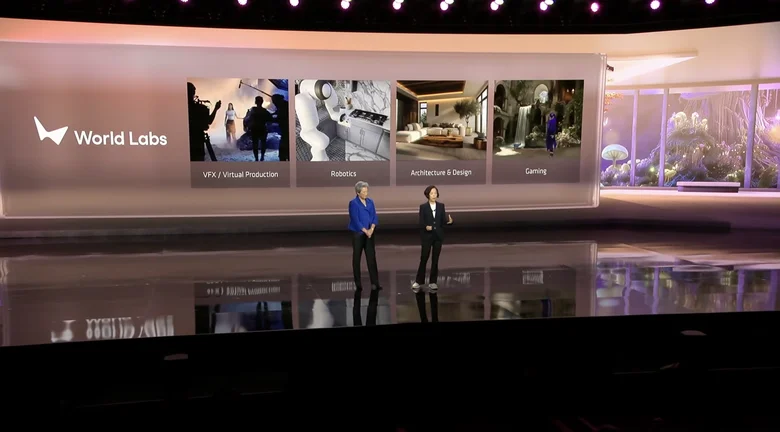
苏姿丰在官方新闻稿中的表态恰好接住这份诉求:“建设下一代 AI 的计算平台,需要深刻理解模型将如何演进。” 从个人早期投资、联合优化、CES 同台、B 轮入局到全资收购,她用两年完成逼近。李飞飞则承诺,并入 AMD 后继续做开放模型与平台、端到端打通硬件软件模型与数据,建一家“能存在数十年”的前沿研究组织。她的未来清单上有药物研发、人类创造力、学习方式和下一代机器人。
雄心很满,但公开信息里也摆着几行让人冷静的数字。评测基准 What-If World 今年用 319 组配对提示考了九个视频生成模型:在“改动一个物理变量会发生什么”的题目上,最强者也只有 51.7%,和抛硬币差不多。World Labs 自己则从未披露营收或客户规模,82 亿美元的买价里,几乎找不到当期收入做锚点。
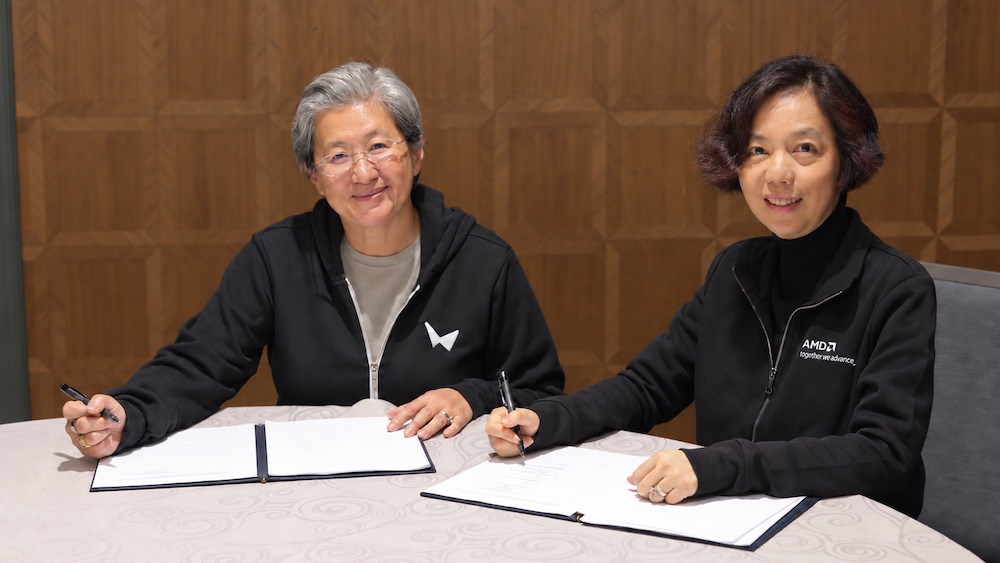
公告当天,苏姿丰转发了这封公开信,配图是两人在签约桌前微笑的合影。李飞飞说自己此刻感受到的是“深深的谦逊、感激和希望”。诗里的尤利西斯驾旧船再度远航,李飞飞选择登上一艘更大的船,把航线并入一家芯片公司的版图。“某种意义上,我过去整个职业生涯都在走向这一刻。” 她用 26 年让机器学会“看见”,用 31 个月证明机器可以“生成世界”,接下来要让这些世界跑进机器人的身体里。
新世界还没建成,船已经离岸。